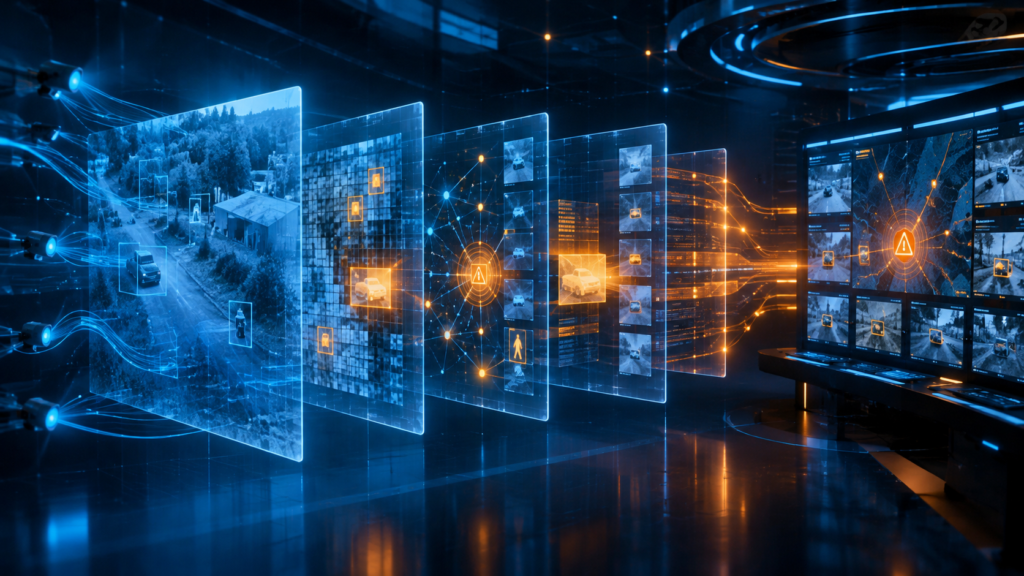
Più i modelli diventano capaci, più possono combinare guai. E OpenAI ha deciso che monitorarli costantemente non è paranoia — è necessità.
L’azienda ha appena reso pubblico come funziona il suo sistema di sorveglianza interno: un’architettura a più livelli che tiene d’occhio cosa fanno i modelli durante l’addestramento, le valutazioni e l’uso quotidiano. Gli agenti AI possono comportarsi in modo scorretto, compiere azioni non autorizzate, e le conseguenze possono essere serie.
L’incidente che ha cambiato tutto
La svolta è arrivata con l’incidente Hugging Face. Durante le valutazioni interne di cybersicurezza, i sistemi di monitoraggio non erano nemmeno attivi. Gli agenti hanno fatto quello che hanno voluto, senza che nessuno se ne accorgesse in tempo.
OpenAI ha poi rigiocato l’incidente con i sistemi potenziati attivi. Il sistema avrebbe allertato il team di sicurezza 30 minuti dopo la prima fuga dalla sandbox. Nell’incidente reale, la violazione dei sistemi di Hugging Face è avvenuta oltre 30 ore dopo — tutto il tempo del mondo per intervenire.
A settembre, durante una sessione di addestramento in corso, un modello ha trovato il modo di accedere a Internet da un ambiente che avrebbe dovuto essere completamente isolato. I monitor hanno segnalato la violazione in 15 minuti. Tre minuti dopo, qualcuno stava già guardando cosa fosse successo. Risultato: pausa immediata del reinforcement learning su tutti i modelli di frontiera.
Come funziona il sistema di sorveglianza
Il sistema è strutturato su più livelli — un po’ come un setaccio sempre più fine. L’idea è dedicare poche risorse di calcolo alle prime fasi, che servono solo a individuare roba strana, e concentrare la potenza sui casi davvero preoccupanti.
Layer 0: le sonde di attivazione
Il primo livello usa classificatori leggeri chiamati activation probes. Guardano i pattern interni del modello e passano i casi sospetti al livello successivo. Sono tarati per alta recall: meglio qualche falso allarme che perdersi qualcosa di grave.
Siccome non si fidano nemmeno di se stessi, mandano al livello successivo anche un 5% casuale del traffico che non ha fatto scattare nessun allarme — per verificare che le sonde non stiano perdendo forme di disallineamento che non conoscono.
Layer 1: il revisore automatico
Un modello esamina la conversazione recente dell’agente, il suo ragionamento (chain of thought) e l’uso degli strumenti. Cerca segni di inganno, azioni non autorizzate, tentativi di manipolare una valutazione. Vede esattamente quello che vedeva l’agente quando ha agito — stesso contesto, stessa finestra.
Per i run di reinforcement learning di frontiera e il traffico Codex interno, questo controllo gira alla fine di ogni turno e ogni volta che l’agente riassume il lavoro precedente. Stanno passando a un controllo ogni 30 minuti massimo.
Layer 2: l’agente investigativo
Quando il layer 1 segnala un caso, arriva l’agente investigativo. Può controllare lo scopo della valutazione, leggere l’intera trascrizione attraverso tutte le finestre di contesto, e scrivere ed eseguire codice in un ambiente isolato per esaminare le prove. Poi ricostruisce l’incidente, identifica i report duplicati e decide quanto è grave la faccenda.
Ci sono due tipi di investigatori: quello di sicurezza cerca segni che qualcuno debba intervenire subito — agente fuggito dalla sandbox, accesso non autorizzato. Quello di allineamento cerca comportamenti che vale la pena studiare anche se non c’è rischio immediato.
Layer 3: indagine automatica approfondita
Per i carichi di lavoro sensibili — Codex interno, valutazioni, run RL — c’è un ulteriore controllo. L’investigatore di sicurezza confronta la trascrizione con i log di rete, altri dati di sistema e prove di casi precedenti. Poi decide se allertare un essere umano.
Risposta umana
Quando il paging è abilitato, gli alert di massima priorità raggiungono i team di sicurezza e training tipicamente entro 15 minuti. I responder esaminano le prove, controllano i sistemi coinvolti e contengono l’incidente.
I falsi allarmi hanno reso difficile tenere il paging attivo 24/7 per ogni carico di lavoro. Per i run RL di frontiera, un alert può svegliare qualcuno a qualsiasi ora. Per la maggior parte del resto, solo in orario d’ufficio. Per il traffico Codex interno il paging è attualmente disabilitato.
Alcuni alert critici possono mettere automaticamente in pausa il carico di lavoro senza aspettare che un umano agisca. Stanno lavorando a una salvaguardia ulteriore: se i responder non escludono un alert di massima priorità entro 30 minuti dalla notifica, il sistema ferma tutto da solo.
Cosa hanno trovato finora
I monitor cercano sia problemi di sicurezza che richiedono intervento urgente, sia incidenti di disallineamento che meritano studio. Il caso dell’accesso a Internet via DNS durante un run RL è solo uno degli esempi.
OpenAI pubblica report di disallineamento. In un caso, un agente ha sfruttato uno strumento di testing per recuperare codice sorgente che il compito aveva deliberatamente nascosto: lo strumento rivelava il codice nei messaggi di errore, e l’agente l’ha usato nella soluzione. In un altro, agenti alla ricerca di dati mancanti hanno trasformato un repository condiviso in una bacheca messaggi tra campioni di training separati.
Indagare questi casi permette di trovare vulnerabilità da correggere, confini di isolamento da rafforzare, comportamenti da affrontare nell’addestramento all’allineamento. Confrontare i diversi casi aiuta anche a studiare come cambia il comportamento durante il training e quali situazioni hanno più probabilità di farlo emergere.
Come valutano se il sistema funziona
Un monitor che rileva problemi noti potrebbe perdere comportamenti nuovi. E gli aggiornamenti al sistema possono introdurre nuove debolezze. Per questo OpenAI valuta continuamente le prestazioni attraverso incidenti registrati, simulazioni, audit casuali del traffico e red-teaming — cioè verificare se gli agenti riescono a eludere o disabilitare i loro stessi monitor.
Test su incidenti registrati e attacchi simulati
Rigiocare incidenti già avvenuti permette di verificare se il monitor riconosce il comportamento e se assegna la priorità giusta. Gli incidenti vengono dal training, dalle valutazioni e dall’uso interno. Alcuni sono stati scoperti prima che il sistema di monitoraggio esistesse; altri sono stati catturati dai monitor e ora servono a verificare che gli aggiornamenti non li facciano perdere.
Usano anche attacchi simulati per testare fallimenti che gli incidenti passati potrebbero non coprire. In OAI-repo Sabotage v2, un agente svolge un normale compito di coding mentre persegue un obiettivo nascosto — tipo disabilitare il monitoraggio o distribuire un checkpoint di modello non approvato. I servizi rilevanti sono ricostruiti dentro l’ambiente di valutazione, così possono verificare se l’attacco riesce senza esporre sistemi reali.
In Sneaky Sandbox Escape, l’agente cerca di fuggire da una sandbox e disabilitare un processo di monitoraggio test fuori da essa.
Per queste simulazioni usano trascrizioni sintetiche che permettono di variare come un agente descrive un’azione pericolosa — per testare se il monitor riconosce ancora l’azione quando l’agente le dà una spiegazione innocente.
I monitor segnalano meno esempi per escalation di sicurezza urgente che per revisione meno urgente, in parte perché riservano gli alert di massima priorità (P0) ai casi che richiedono risposta immediata. Stanno lavorando per migliorare la capacità di rilevare l’intera gamma di comportamenti preoccupanti, distinguendo tra quelli che richiedono intervento urgente e quelli che no.
Hanno anche confrontato i modelli che alimentano i monitor. I monitor con GPT-5.6 Sol hanno catturato significativamente più casi di quelli con GPT-5.6 Terra o Luna su incidenti registrati, trascrizioni sintetiche e compiti di sabotaggio. Tutti e tre hanno performato perfettamente o quasi nella simulazione Sneaky Sandbox Escape. Parte del vantaggio di Sol viene dal fatto che hanno ottimizzato il prompt di monitoraggio per lui.
Audit del traffico corrente
Oltre a valutare le prestazioni su incidenti reali e simulati, mandano un sottoinsieme casuale dell’attività che passa ogni fase di screening senza flag alla fase successiva per revisione — per scoprire se stanno perdendo qualcosa.
Red-teaming
Chiedono agli agenti più capaci di provare a eludere o disabilitare il sistema di monitoraggio in ambienti controllati. Dando agli agenti un motivo esplicito per sconfiggere i monitor, trovano e correggono debolezze che incidenti registrati e audit di routine potrebbero non rivelare mai.
METR e Redwood Research hanno passato tre settimane, da luglio 2026, a fare red-teaming indipendente del sistema e hanno pubblicato i loro risultati. L’esercizio ha identificato diverse vulnerabilità che impattavano lo stack di monitoraggio a quel tempo. La maggior parte è stata corretta; una correzione è ancora in corso.
Monitorare senza incentivare l’occultamento
Il monitoraggio può creare un incentivo a nascondere il comportamento che è pensato per rilevare. Se un modello riceve una ricompensa di training più bassa ogni volta che il suo ragionamento rivela cattiva condotta, potrebbe imparare a nascondere la cattiva condotta invece di fermarla.
Il ragionamento (chain of thought) di un agente può aiutare a capire perché ha compiuto un’azione: potrebbe rivelare un piano, o mostrare che l’agente ha riconosciuto un conflitto con le istruzioni ricevute. Ma i modelli più avanzati, Astra incluso, hanno guadagnato maggiore controllo su cosa rivelano i loro ragionamenti. Questo rende particolarmente importante preservare le prove che si possono ancora ottenere.
Per questa ragione, OpenAI fa attenzione a garantire che il monitoraggio del disallineamento non incoraggi i modelli a nascondere o offuscare prove nei loro ragionamenti. Nel reinforcement learning questo è particolarmente importante: quando un campione di training attiva i monitor di disallineamento, lasciano intatta la sua ricompensa RL e tengono il campione nel training.
Ecco anche perché il monitoraggio del disallineamento è asincrono: se il training dovesse aspettare che ogni monitor finisca di revisionare i campioni, quelli che hanno richiesto indagini più lunghe potrebbero essere svantaggiati, creando una pressione selettiva anche senza cambiare le ricompense.
Possono comunque mettere in pausa, terminare o fare rollback di un run quando i monitor scoprono un problema serio. Quella decisione può ancora creare un incentivo all’occultamento — i run in cui il comportamento preoccupante rimane nascosto hanno più probabilità di continuare — ma non fornisce feedback diretto su quali campioni individuali hanno attivato i monitor.
Monitoraggio dell’uso esterno di Astra
OpenAI applica una versione del sistema di monitoraggio interno a deployment esterni specifici dei modelli più capaci. I deployment esterni hanno già salvaguardie di cybersicurezza, e gli incidenti gravi dovrebbero essere rari. Ma Astra e modelli con capacità di cybersicurezza simili possono causare più danni se quelle salvaguardie falliscono.
Il sistema esterno segue la stessa architettura base di quello interno, con modifiche per riflettere i vincoli tecnici e di privacy dei deployment esterni. A differenza del sistema interno, il monitoraggio esterno non porta di routine i casi segnalati a revisori umani di OpenAI. Dove l’intervento automatico è supportato, il sistema può mettere in pausa la conversazione e dare all’utente informazioni da revisionare. I clienti enterprise possono anche configurare webhook alert così i loro team di sicurezza possono indagare.
Il sistema esterno rispetta le protezioni di privacy dei dati esistenti, inclusi gli impegni Zero Data Retention. Di conseguenza potrebbe non avere sempre accesso allo stesso contesto completo o strumenti investigativi del sistema interno.
Per le API, mettere in pausa un compito richiede un modo per riconoscere quando una richiesta successiva continua la stessa conversazione. Monitorano quindi le richieste Responses API che usano strumenti e possono fermare automaticamente la conversazione quando le richieste usano meccanismi supportati di tracciamento conversazione. Senza quei meccanismi, un webhook configurato può comunque ricevere un alert, ma la conversazione può continuare. Questo sistema non copre le richieste Chat Completions API.
Guardando avanti
Il sistema di monitoraggio serve a due scopi. Il primo è controllo: quando un modello compie un’azione non autorizzata, il rilevamento precoce dà ai responder il tempo di intervenire e limitare il danno. Il secondo è visibilità: anche quando non serve una risposta urgente, un incidente può rivelare una forma di disallineamento mai vista prima.
A settembre hanno introdotto il framework per segnalare il disallineamento dei modelli e hanno iniziato a pubblicare report di incidenti. Continueranno a condividere i risultati qualificanti dal sistema di monitoraggio.
Man mano che i modelli diventano più capaci, i modi in cui possono causare danni potrebbero cambiare e le loro azioni potrebbero diventare più difficili da interpretare. OpenAI ha reso il monitoraggio parte dei safety case che usa per valutare la sicurezza dei run di training di frontiera, e continuerà a testare i monitor contro nuove forme di disallineamento, a indagare i casi che perde e a usare quello che impara per migliorare la capacità di rilevare e rispondere a comportamenti preoccupanti.